
Artículo
6 min read
Cómo Deel Eliminó 900 Horas De Ingeniería Por Apagar Incendios Con Un Sistema De IA De 4 Agentes
IA
Autor
Harshil Jain
Última actualización
9 de septiembre de 2026
A escala, la nómina parece sencilla en teoría. Usted contrata más rápido, sincroniza más registros y, además, cumple con la normativa. Pero si su tasa de fallos se mantiene aproximadamente constante mientras aumenta el volumen, el número absoluto de fallos crece al mismo ritmo que sus contrataciones. Si su equipo de ingeniería no crece al mismo ritmo, de repente pasa más tiempo investigando fallos y menos tiempo construyendo lo que realmente importa.
En Deel procesamos la nómina PEO de EE. UU. para miles de nuevas contrataciones de forma continua, y cuando una sincronización falla hay un nuevo contratado esperando su primer pago. Eso hizo que nuestro antiguo proceso de triaje fuera imposible de ignorar, no por métricas de eficiencia, sino por lo que realmente nos estaba costando.
El coste real de apagar incendios
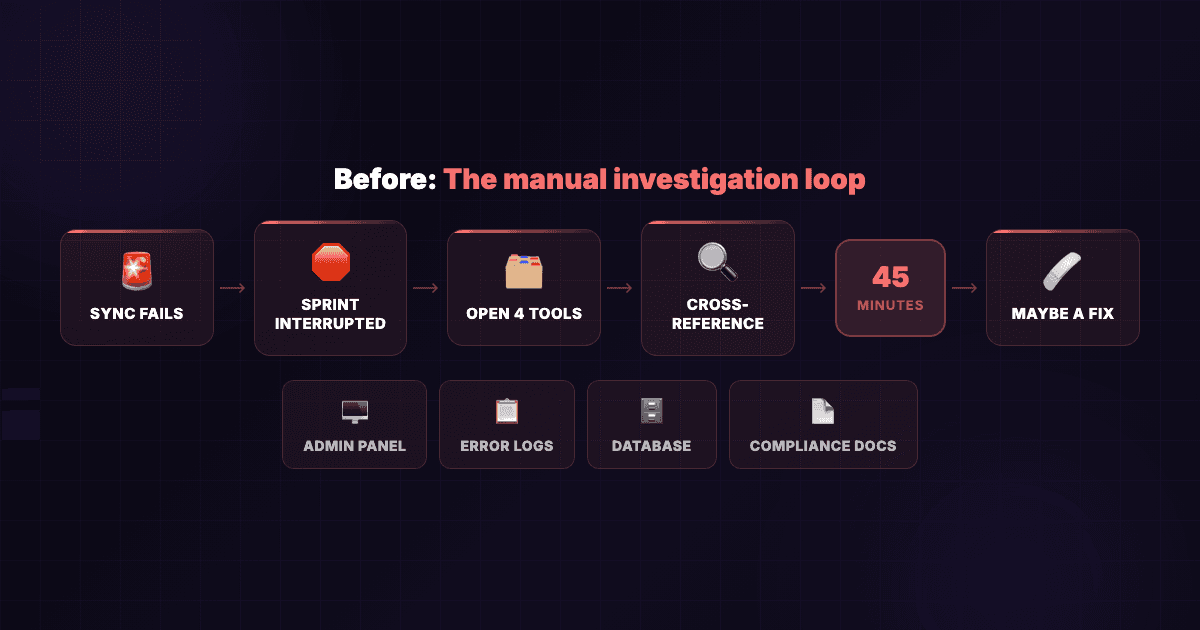
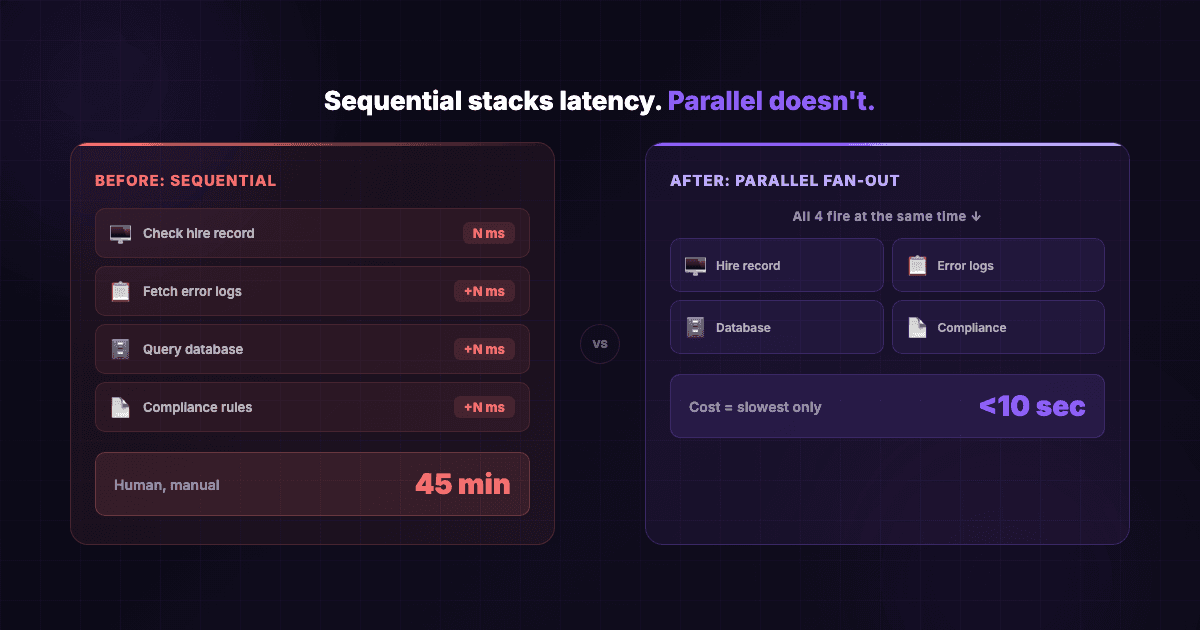
Falla una sincronización de nómina y un ingeniero deja su trabajo del sprint para investigar el problema. Lo que ocurría a continuación era el patrón que seguíamos viendo repetido: abrían cuatro herramientas distintas a la vez —nuestro sistema de nómina, la base de datos de registros de contratación, los registros de errores y las normas de cumplimiento laboral— y pasaban los siguientes 45 minutos reconstruyendo qué había ido mal, cruzando mensajes de error y el estado del sistema entre todas ellas.
Un pico de fallos, algo nada infrecuente durante los periodos de alta contratación, podía consumir el día entero de un equipo de ingeniería investigando. Estábamos destinando nuestro recurso más caro al trabajo de menor valor.
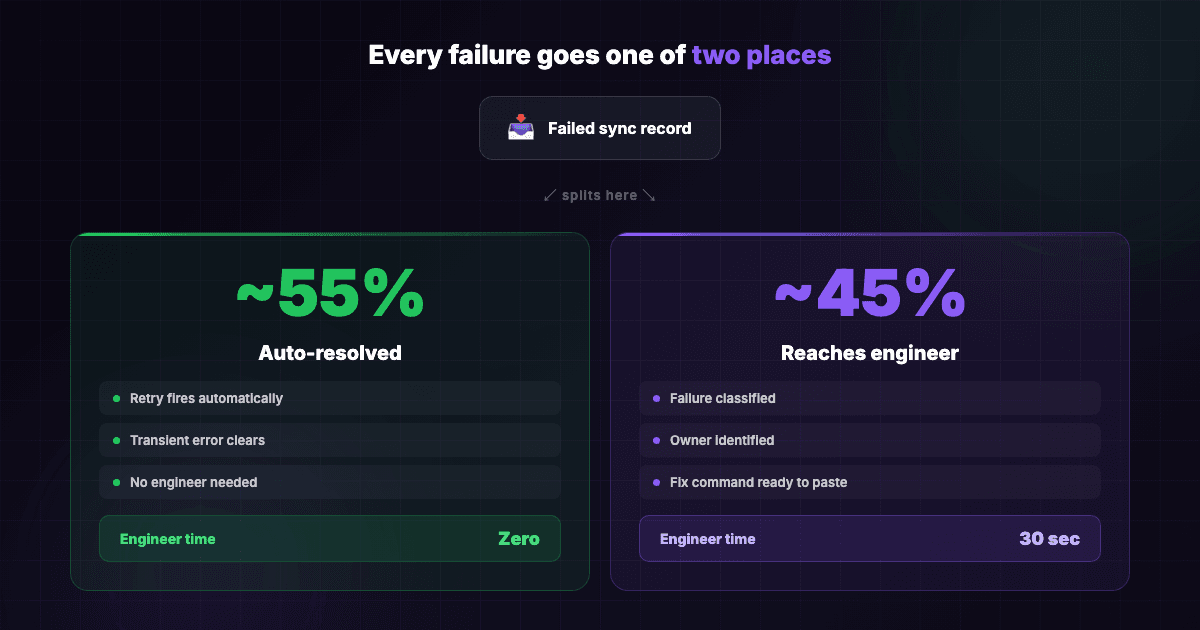
Al investigarlo, alrededor del 55 % de las fallas eran transitorias; bloqueos de la base de datos durante ventanas de alta escritura, condiciones de carrera al finalizar registros de contratación y problemas de sincronización que se resolvían por sí solos. Las condiciones que las causaban ya habían desaparecido cuando alguien las revisaba. Sin un sistema que rastreara los resultados en todos los casos, ese patrón era invisible. Cada fallo parecía un problema único que merecía investigación, ya que ninguno se declaraba a sí mismo como «simplemente reintente».
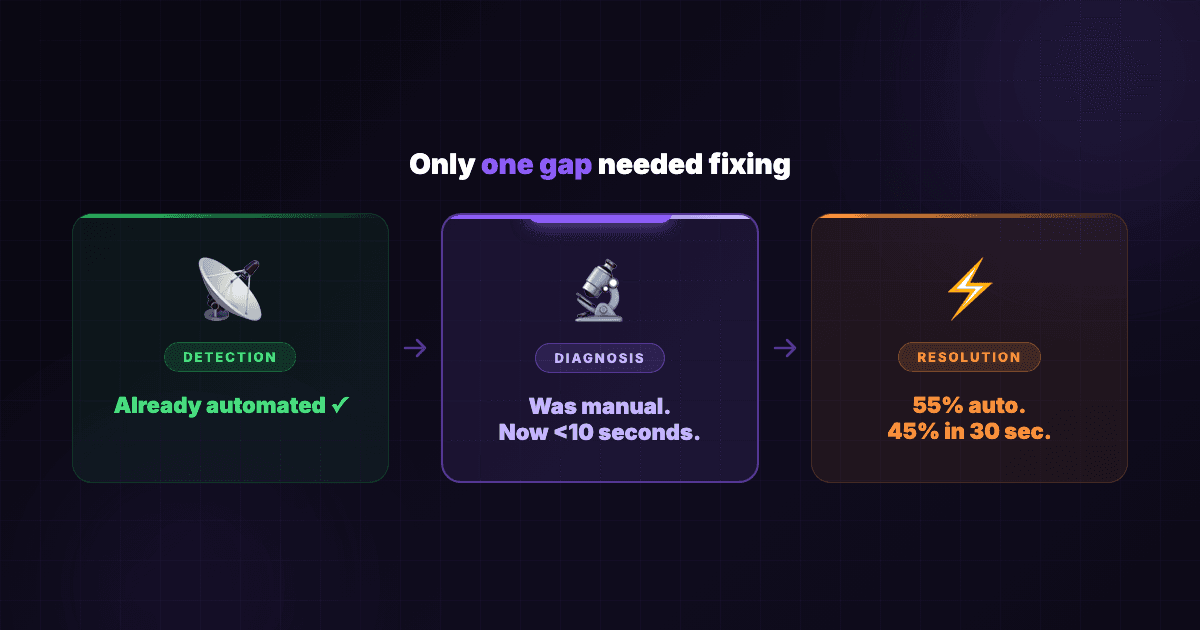
Podríamos haber añadido reintentos con retroceso antes, pero no puede lanzar un reintento sobre un registro de nómina con confianza sin saber primero si el fallo es transitorio o estructural. Si es estructural, un reintento puede agravar el problema, así que el diagnóstico tiene que suceder de cualquier manera. Lo que cambió con el agente es que ambos pasos ocurren en segundos en lugar de que uno se alargue 45 minutos.
Lo que construimos
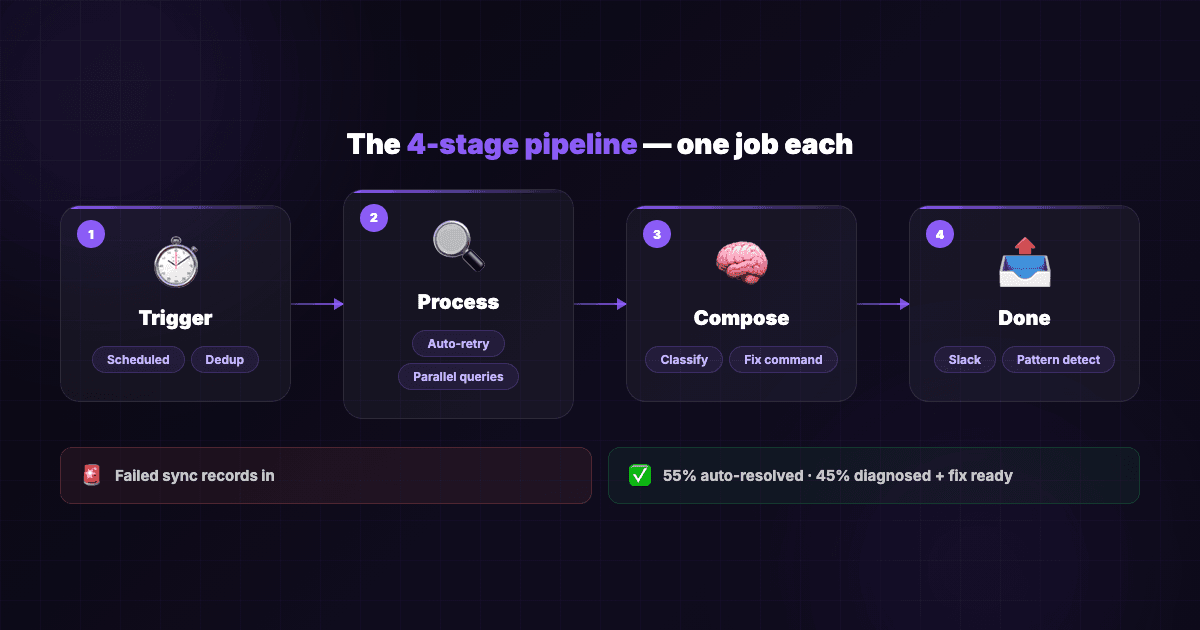
En lugar de centrarnos en cómo investigar los fallos más rápido, empezamos a preguntarnos cómo podríamos evitar la investigación por completo. Desplegamos una canalización de cuatro etapas en Akai, la plataforma interna de orquestación de IA de Deel, donde cada etapa se encarga de una tarea específica y la entrega de forma limpia a la siguiente sin intervención manual ni necesidad de que un ingeniero la active.
Etapa 1: Detección y agrupamiento
Cada pocos minutos esta etapa se activa, escanea el sistema de nómina en busca de sincronizaciones fallidas, las desduplica y agrupa los fallos relacionados antes de pasar un lote limpio aguas abajo, todo sin requerir un ping en Slack ni un disparador humano.
Etapa 2: Reintento e investigación
Esta etapa lanza un reintento automático para cada fallo, y en aproximadamente el 55 % de los casos eso es todo —el error transitorio se corrige solo y no es necesaria investigación. Para el 45 % restante, se expande en paralelo para comprobar el estado del registro de contratación, extraer registros de los sistemas de monitorización, consultar la base de datos de nómina y cruzar las reglas de cumplimiento, todo al mismo tiempo. Ninguna de esas operaciones bloquea a las demás, por eso el diagnóstico se obtiene en menos de 10 segundos aunque toque cuatro sistemas distintos.
Etapa 3: Clasificación y remediación
Esta etapa traduce el ruido del sistema en significado real al categorizar el fallo —SSN duplicado, dirección inválida, estado de presentación de impuestos faltante, datos de enrutamiento erróneos, y otros similares— y después hace lo que antes consumía la mayor parte del tiempo de un ingeniero: determina de quién es realmente el problema, si corresponde al empleador, al empleado o a Deel, y escribe el comando exacto necesario para arreglarlo.
Etapa 4: Entrega
La etapa final empaqueta todo en Slack con una sección por cada fallo, comandos listos para copiar y pegar y enlaces directos a los registros; además, analiza los casos para reconocer cuando el mismo error se repite entre varias incorporaciones de la misma empresa, sacándolo como un único problema de configuración a nivel de empleador en lugar de inundar al equipo con diez alertas individuales.
El problema de 45 minutos que nos negamos a aceptar
Los números hablan por sí mismos:
| Métrica | Antes | Después |
|---|---|---|
| Tiempo por triaje | 45 minutos | Menos de 10 segundos |
| Capacidad máxima | Día completo de ingeniería para 4-6 casos | 20+ casos simultáneamente |
| Resolución automática | 0 % | 55 % |
| Horas recuperadas al año | — | 900+ |
Los ingenieros no desaparecieron del proceso, pero el dolor sí. Aproximadamente el 55 % de los casos ahora se resuelven solos sin que nadie los toque, y el resto sigue llegando a un ingeniero. Sin embargo, ahora llegan como una revisión de 30 segundos en lugar de una investigación de 45 minutos, lo que significa que el ingeniero sabe exactamente qué está fallando y qué necesita hacerse a continuación.
Cómo lo hacemos
Esto no es específico de Deel ni la arquitectura es novedosa. Se aplica a cualquier reto de triaje de infraestructura que pueda tener. Esto es lo que realmente funcionó para nosotros:
Etapas secuenciales con operaciones paralelas internas. Cada etapa se ejecuta después de que la anterior termina, pero la ganancia crítica de rendimiento ocurre dentro de la etapa de Investigación, donde todas las obtenciones de datos se disparan al mismo tiempo, de modo que ninguna bloquea a otra, y esa es la diferencia entre una operación de 40 segundos y una de 10 segundos.
Taxonomía de fallos específica. La etapa de Clasificación tiene una taxonomía estructurada de tipos de fallo, y lo bueno de este enfoque es que añadir una nueva categoría de fallo cuando aparece algo en producción es simplemente un cambio de una línea en el prompt.
Transferencias JSON limpias entre etapas. Cada etapa toma JSON limpio, hace su trabajo y produce JSON limpio, lo que significa que no hay estado compartido ni dependencias misteriosas.
Reintento inmediato por defecto. La mayoría de los fallos son transitorios, así que la lógica es simple —reintentar de inmediato, medir qué porcentaje se resuelve solo y luego investigar lo que queda.
Más allá de la nómina
El sistema de nómina es nuestro caso de uso, pero el patrón escala a cualquier lugar donde la infraestructura sea ruidosa, ya sean fallos de API, incidentes de base de datos, errores de proveedores en la nube o escalados de soporte al cliente en los que hay alto volumen, señal enterrada en ruido y la necesidad de separar lo que puede solucionarse automáticamente de lo que realmente necesita intervención humana. Aunque las herramientas específicas cambian, la lógica permanece igual: reintentar, diagnosticar, clasificar, enrutar.
La mayoría de las organizaciones derivan todo a personas y esperan que lo solucionen, y esto funciona hasta que contrata rápido y el volumen desborda al equipo. Automatice lo que pueda y reserve el juicio humano para lo que no pueda automatizar.
Cómo ayuda Deel
La plataforma de Deel gestiona la complejidad de la nómina, de modo que sus ingenieros no tengan que dedicar su tiempo a investigarla; lo hacemos mediante flujos de trabajo orquestados por IA que gestionan las tareas de alto volumen y poca señal. Sus ingenieros pueden centrarse en lo que realmente les necesita: incorporar resiliencia al sistema y asegurarse de que estas fallas no ocurran en primer lugar —en lugar de pasar los días apagando incendios.
Reserve su demo de Deel, y vea cómo es escalar global payroll sin los dolores de cabeza.
Harshil Jain es desarrollador backend en Deel, apasionado por construir sistemas escalables y resolver problemas complejos de ingeniería. Disfruta explorando tecnologías emergentes, en particular la IA, y compartiendo ideas sobre la ingeniería de software y el futuro del trabajo.