
Artigo
6 min read
Como o Deel Eliminou 900 Horas de Engenharia a Apagar Incêndios com Um Sistema De IA de 4 Agentes
IA
Autor
Harshil Jain
Última atualização
9 de setembro de 2026
Escalar a folha de pagamento parece simples na teoria. Está a contratar mais rápido, a sincronizar mais registos, tudo enquanto se mantém em conformidade. Mas se a sua taxa de falhas se mantiver aproximadamente constante enquanto o volume sobe, o número absoluto de falhas cresce ao mesmo ritmo das contratações. Se a sua equipa de engenharia não crescer na mesma proporção, de repente passa a gastar mais tempo a investigar falhas e menos tempo a construir o que realmente importa.
No Deel, processamos a folha de pagamento PEO dos EUA para milhares de novas contratações de forma contínua, e quando uma sincronização falha, há um novo trabalhador à espera do seu primeiro pagamento. Isso tornou impossível ignorar o nosso antigo processo de triagem, não por nos importarmos com métricas de eficiência, mas pelo custo real que nos acarretava.
O verdadeiro custo de apagar incêndios
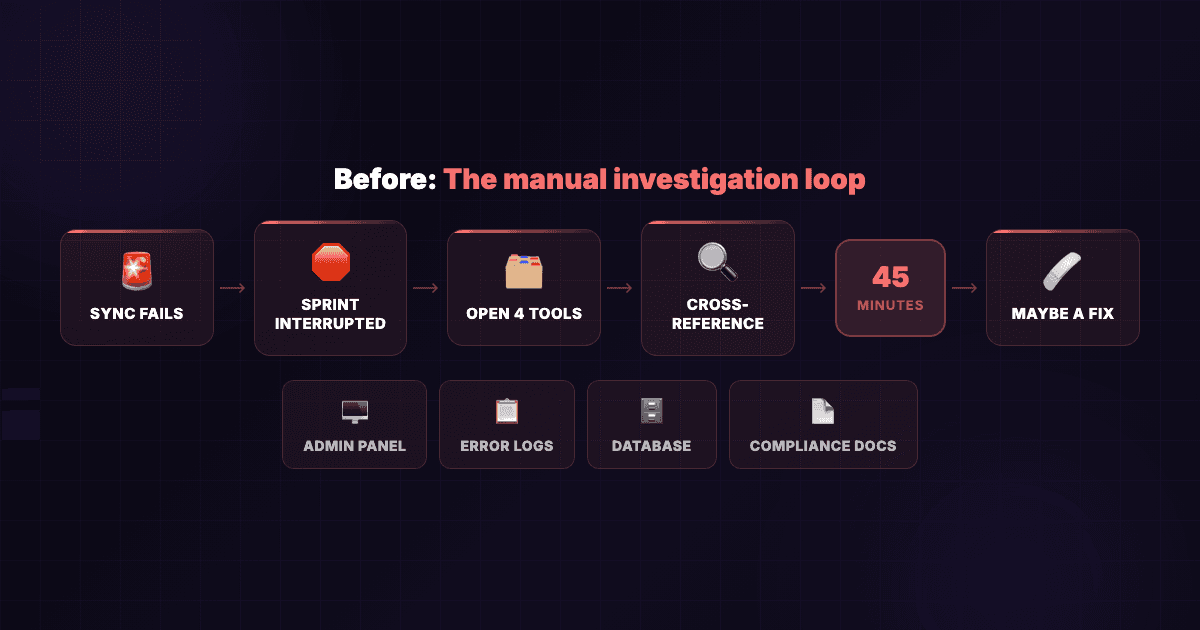
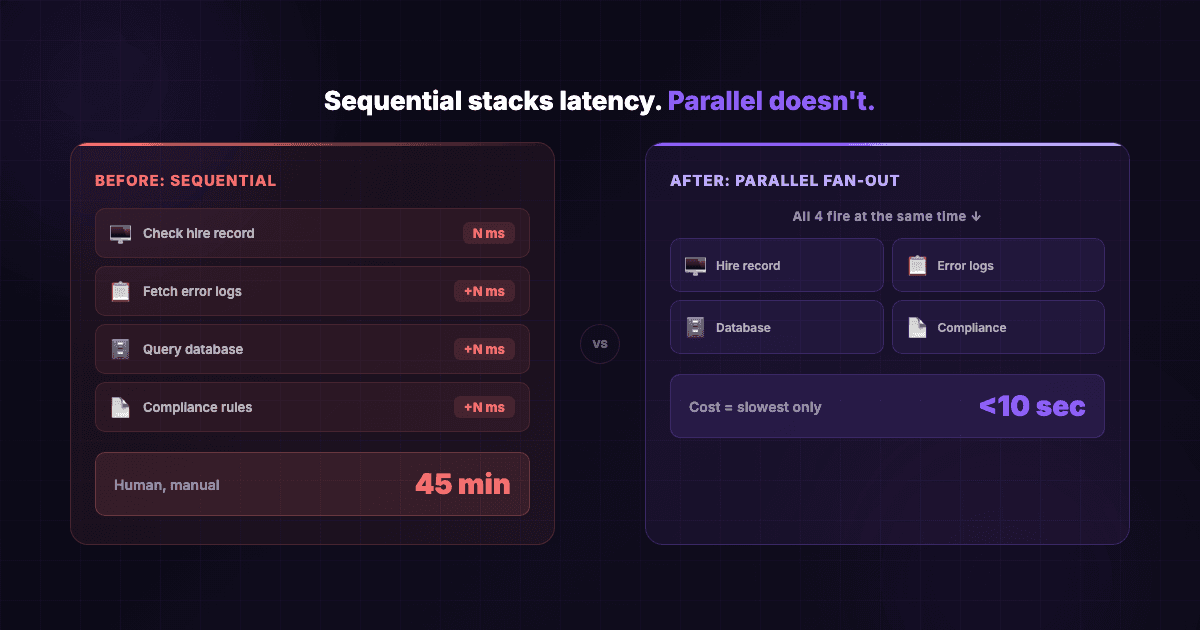
Uma sincronização de folha de pagamento falha, e um engenheiro abandona o trabalho do sprint para investigar o problema. O padrão que víamos repetir-se era este: abriam quatro ferramentas em simultâneo — o nosso sistema de folha de pagamento, a base de dados de registos de contratação, os registos de erro e as regras de conformidade laboral — e passavam os 45 minutos seguintes a reconstruir o que correu mal, cruzando mensagens de erro e o estado do sistema entre todas elas.
Um pico de falhas, que não era invulgar durante os períodos de contratação intensa, podia consumir o dia inteiro de uma equipa de engenharia a investigar. Estávamos a canalizar o nosso recurso mais caro para o trabalho menos valioso.
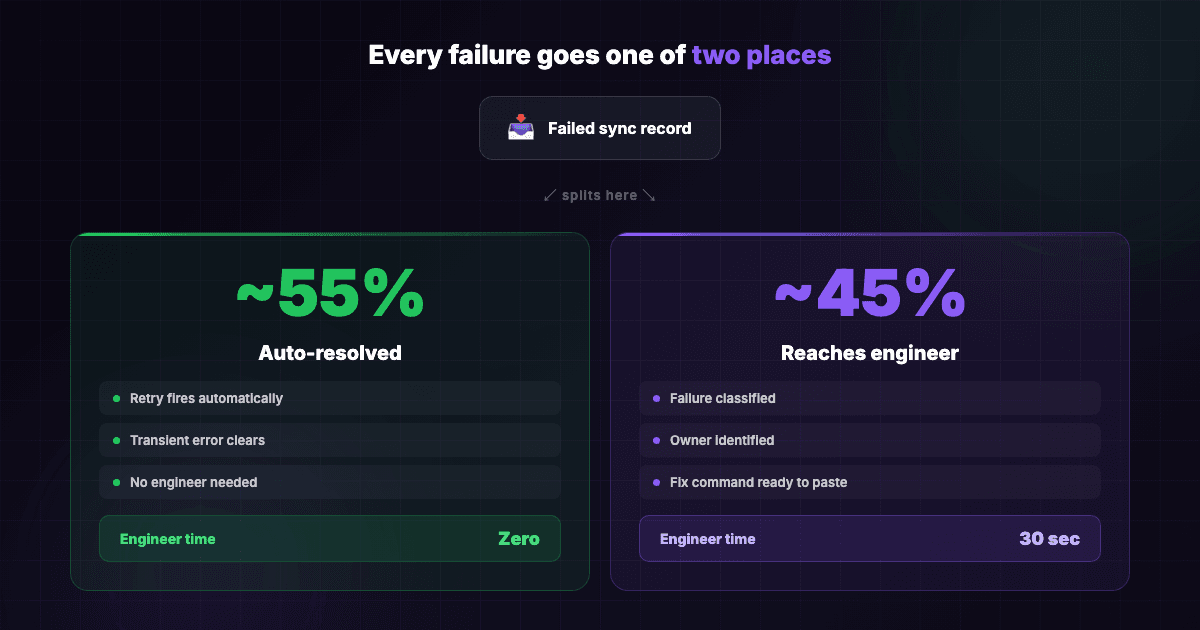
Ao analisarmos, cerca de 55% das falhas eram transitórias; bloqueios na base de dados durante janelas de escrita intensiva, condições de corrida na finalização dos registos de contratação e problemas de temporização que se resolviam sozinhos. As condições que as causavam já tinham desaparecido quando alguém as analisava. Sem um sistema a acompanhar os resultados de cada caso, esse padrão era invisível. Cada falha parecia um problema único que merecia investigação, já que nenhuma delas dizia "apenas volte a tentar".
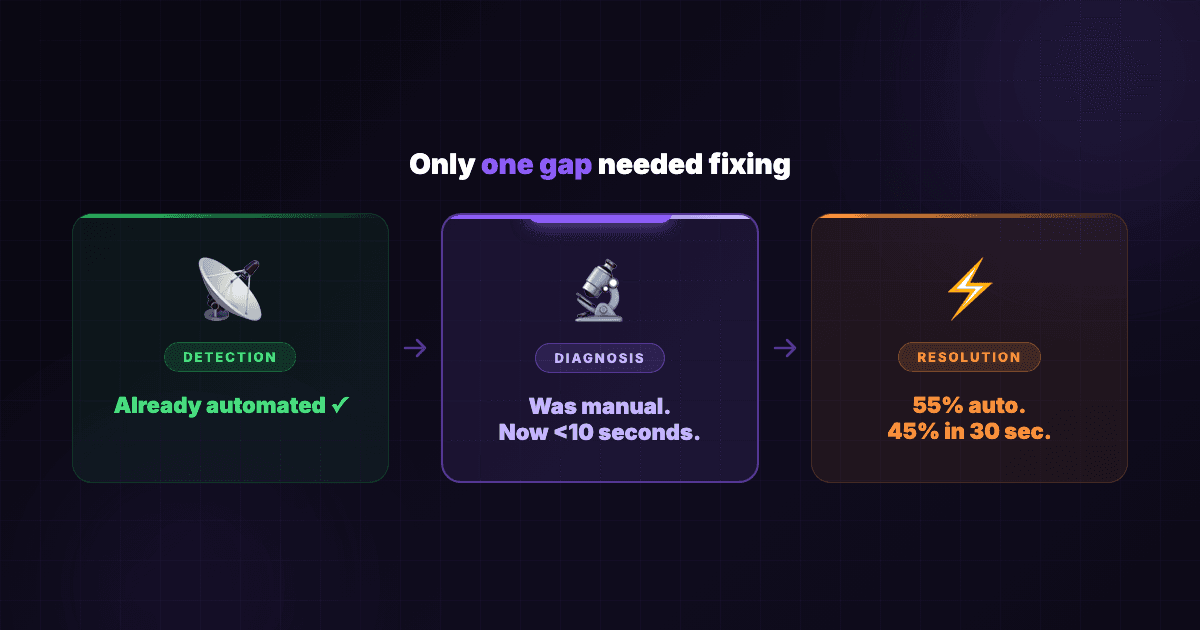
Poderíamos ter implementado uma retentativa com backoff mais cedo, mas não se pode disparar uma retentativa numa ficha salarial com confiança sem primeiro saber se a falha é transitória ou estrutural. Se for estrutural, uma retentativa pode agravar o problema, pelo que o diagnóstico tem de acontecer de qualquer modo. O que o agente mudou foi que ambos acontecem em segundos, em vez de um demorar 45 minutos.
O Que Construímos
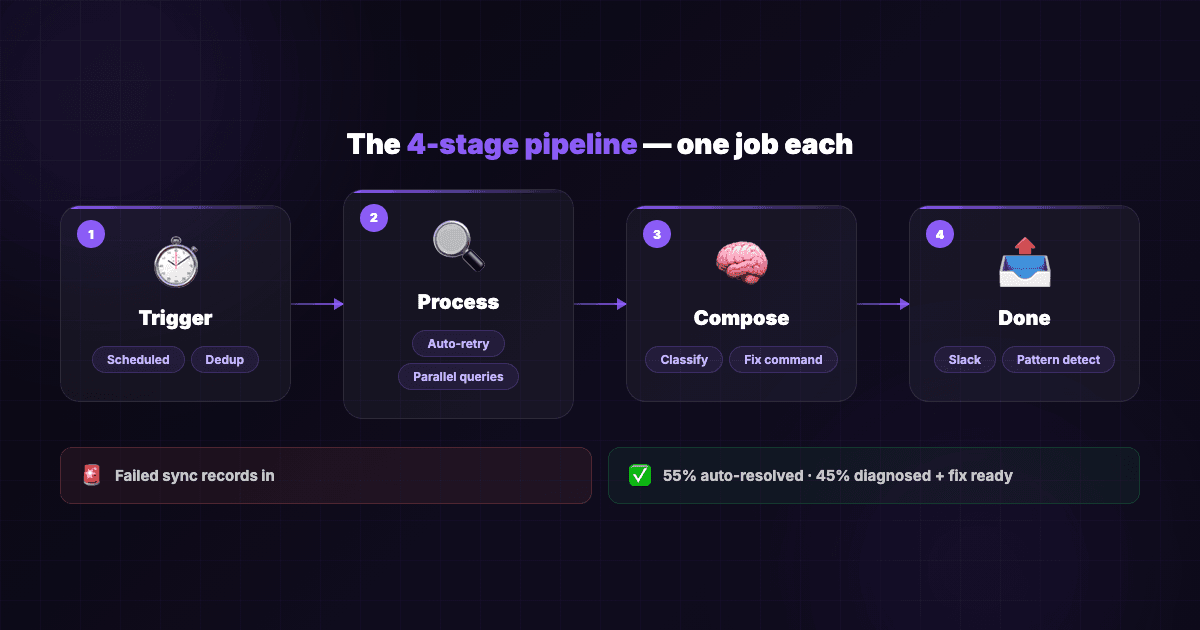
Em vez de nos concentrarmos em como investigar falhas mais depressa, começámos a perguntar‑nos como evitar a investigação por completo. Implementámos uma pipeline de quatro fases no Akai, a plataforma interna de orquestração de IA do Deel, em que cada fase assume uma tarefa específica e entrega limpo para a seguinte sem intervenção manual nem necessidade de um engenheiro a lançá‑la.
Fase 1: Deteção e Agrupamento
De alguns em alguns minutos, esta fase desperta, varre o sistema de folha de pagamento à procura de sincronizações falhadas, elimina duplicados e agrupa falhas relacionadas antes de enviar um lote limpo para jusante — tudo sem precisar de um ping no Slack ou de um acionamento humano.
Fase 2: Repetição e Investigação
Esta fase dispara uma nova tentativa automática em cada falha e, cerca de 55% das vezes, isso resolve tudo — o erro transitório desaparece e não é necessária qualquer investigação. Nos restantes 45% dos casos, expande‑se em paralelo para verificar o estado do registo de contratação, obter logs dos sistemas de monitorização, consultar a base de dados da folha de pagamento e cruzar regras de conformidade ao mesmo tempo. Nenhuma dessas operações bloqueia as outras, por isso o diagnóstico chega em menos de 10 segundos apesar de tocar em quatro sistemas distintos.
Fase 3: Classificação e Remediação
Esta fase traduz o ruído do sistema em significado real, categorizando a falha — SSN duplicado, morada inválida, estado de declaração de impostos em falta, dados de roteamento incorretos, entre outros — e depois faz o que consumia a maior parte do tempo dos engenheiros: determina de quem é a responsabilidade (empregador, trabalhador ou Deel) e escreve o comando exato necessário para resolver o problema.
Fase 4: Entrega
A fase final empacota tudo no Slack com uma secção por falha, comandos de correção prontos a copiar e colar e links diretos para os logs. Além disso, analisa vários casos para reconhecer quando o mesmo erro se repete em várias contratações da mesma empresa, apresentando isso como um único problema de configuração ao nível do empregador em vez de inundar a equipa com dez alertas separados.
O Problema De 45 Minutos Que Recusámos Aceitar
Os números falam por si:
| Métrica | Antes | Depois |
|---|---|---|
| Tempo por triagem | 45 minutos | Menos de 10 segundos |
| Capacidade máxima | Um dia inteiro de engenharia para 4–6 casos | 20+ casos simultaneamente |
| Auto-resolvido | 0% | 55% |
| Horas recuperadas anualmente | — | 900+ |
Os engenheiros não desapareceram do circuito, mas o pesadelo acabou. Cerca de 55% dos casos agora resolvem‑se sozinhos sem intervenção humana; os restantes chegam sempre a um engenheiro, mas como uma revisão de 30 segundos em vez de uma investigação de 45 minutos — o engenheiro sabe exatamente o que está partido e o que deve ser feito de seguida.
Como Fazemos
Isto não é específico do Deel, nem a arquitetura é inédita. Aplica‑se a qualquer desafio de triagem em infraestrutura. Eis o que realmente funcionou para nós:
Etapas sequenciais com operações paralelas no interior. Cada etapa corre depois da anterior terminar, mas o ganho crítico de desempenho acontece na fase de Investigação, onde todas as recolhas de dados disparam ao mesmo tempo, o que significa que nenhuma bloqueia as outras — e essa é a diferença entre uma operação de 40 segundos e uma de 10 segundos.
Taxonomia de falhas específica. A fase de Classificação tem uma taxonomia estruturada de tipos de falha, e a vantagem deste método é que adicionar uma nova categoria de falha quando surge algo em produção é apenas uma alteração de uma linha no prompt.
Transferências JSON limpas entre etapas. Cada etapa recebe JSON limpo, faz o seu trabalho e devolve JSON limpo, o que significa que não há estado partilhado nem dependências misteriosas.
Repetição imediata como predefinição. A maioria das falhas é transitória, por isso a lógica é simples: tentar novamente de imediato, medir a percentagem que se resolve sozinha e, depois, investigar o que resta.
Para Além Da Folha De Pagamento
O sistema de folha de pagamento é o nosso caso de uso, mas o padrão aplica‑se sempre que a infraestrutura fica ruidosa — sejam falhas de API, incidentes de base de dados, erros de fornecedores de cloud ou escalões de suporte ao cliente em que há grande volume, pouco sinal e a necessidade de separar o que pode ser corrigido automaticamente do que exige intervenção humana. As ferramentas específicas mudam, mas a lógica mantém‑se: tentar novamente, diagnosticar, classificar, encaminhar.
A maior parte das organizações encaminha tudo para pessoas e espera que elas resolvam, o que funciona até a equipa ficar sobrecarregada com o ritmo das contratações. Automatize o que puder e reserve o julgamento humano para o que não puder ser automatizado.
Como O Deel Ajuda
A plataforma Deel lida com a complexidade da folha de pagamento para que os seus engenheiros não tenham de perder tempo a investigá‑la. Para isso usamos fluxos de trabalho orquestrados por IA que gerem o trabalho de alto volume e baixo sinal. Os seus engenheiros podem concentrar‑se no que realmente precisa deles: tornar o sistema mais resiliente e garantir que estas falhas não aconteçam em primeiro lugar, em vez de passarem os dias a apagar incêndios.
Agende A Sua Demonstração Do Deel, e veja como é escalar o processamento salarial global sem dores de cabeça.
Harshil Jain é desenvolvedor back-end na Deel, apaixonado por construir sistemas escaláveis e por resolver problemas complexos de engenharia. Gosta de explorar tecnologias emergentes, particularmente IA, e de partilhar insights sobre engenharia de software e o futuro do trabalho.