記事
6 min read
4体のAIエージェントでDeelが900時間のエンジニアの障害対応を削減した方法をご紹介します
AI
著者
Harshil Jain
最終更新日
2026年11月12日
目次
火消し対応がもたらす本当のコスト
私たちが構築しました
受け入れませんでした、45分の問題
どのように実現しているか
給与計算を超えて適用できます
Deelが支援します
給与のスケール化は理論上は単純に見えます。採用が速まり、同期されるレコードが増え、コンプライアンスを維持しながら進めればよいのです。しかし、障害率がほぼ一定で、量だけが増えれば、障害の絶対数は採用のペースに合わせて増加します。エンジニアチームがそれに合わせて増えなければ、彼らは調査に多くの時間を割かれ、本来重要な開発に使う時間が減ってしまいます。
Deelでは、米国のPEO給与処理を多数の新入社員向けに継続的に処理しており、同期が失敗すると新入社員の最初の給与支払いが遅れることになります。そのため、従来のトリアージプロセスは無視できない問題でした。効率指標のためではなく、実際にそれがどれだけのコストを生んでいるかが問題だったのです。
火消し対応がもたらす本当のコスト
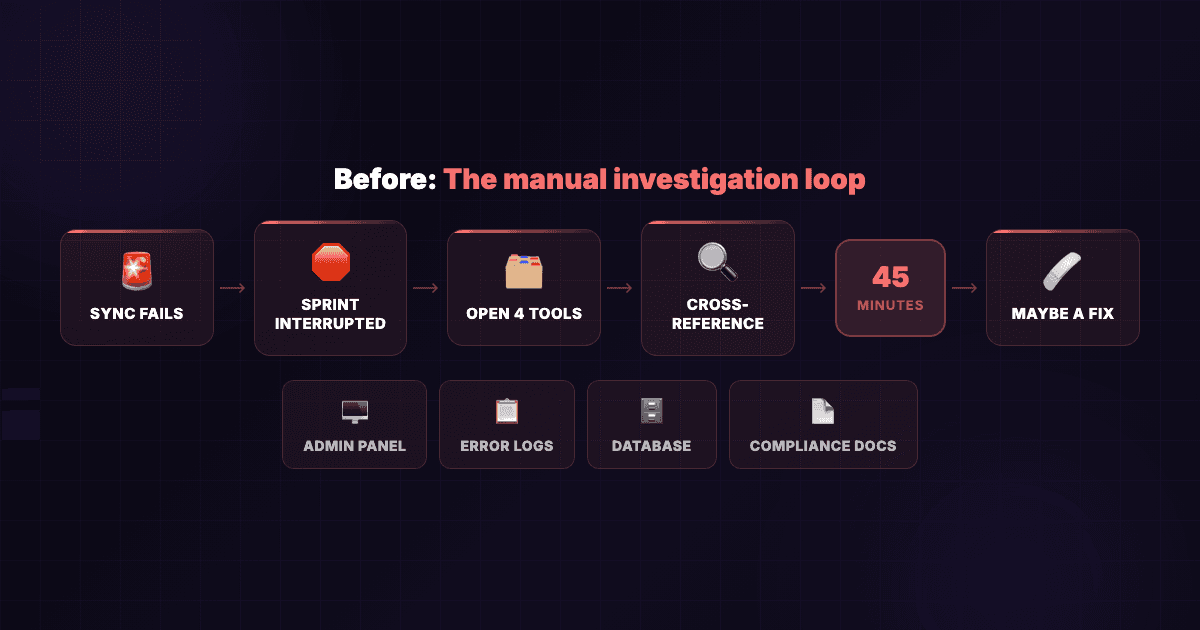
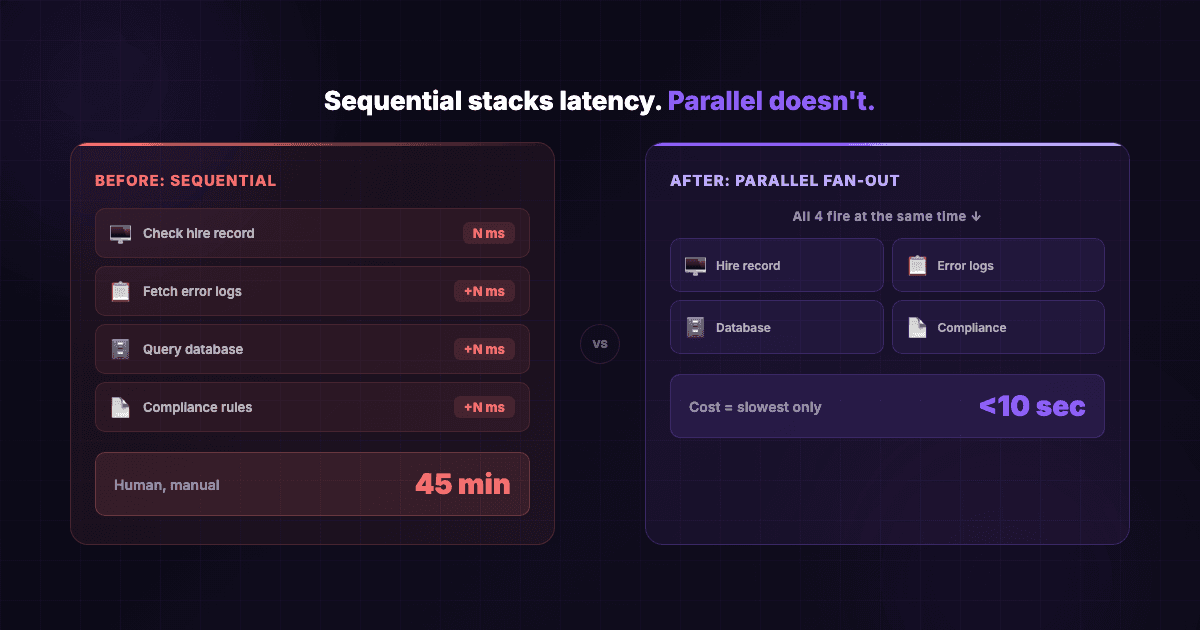
給与の同期が失敗すると、エンジニアはスプリントの作業を中断して問題を調査します。繰り返し見られたパターンはこうです:エンジニアは同時に4つの異なるツールを立ち上げます—給与システム、採用記録データベース、エラーログ、そして雇用コンプライアルール—そして次の45分間をそれらを突き合わせて何が起きたかを再構築することに費やします。
採用ピーク時の障害のスパイクは、エンジニアチームの一日の稼働を丸ごと奪うことがありました。我々は最もコストの高いリソースを、最も価値の低い作業に振り向けていたのです。
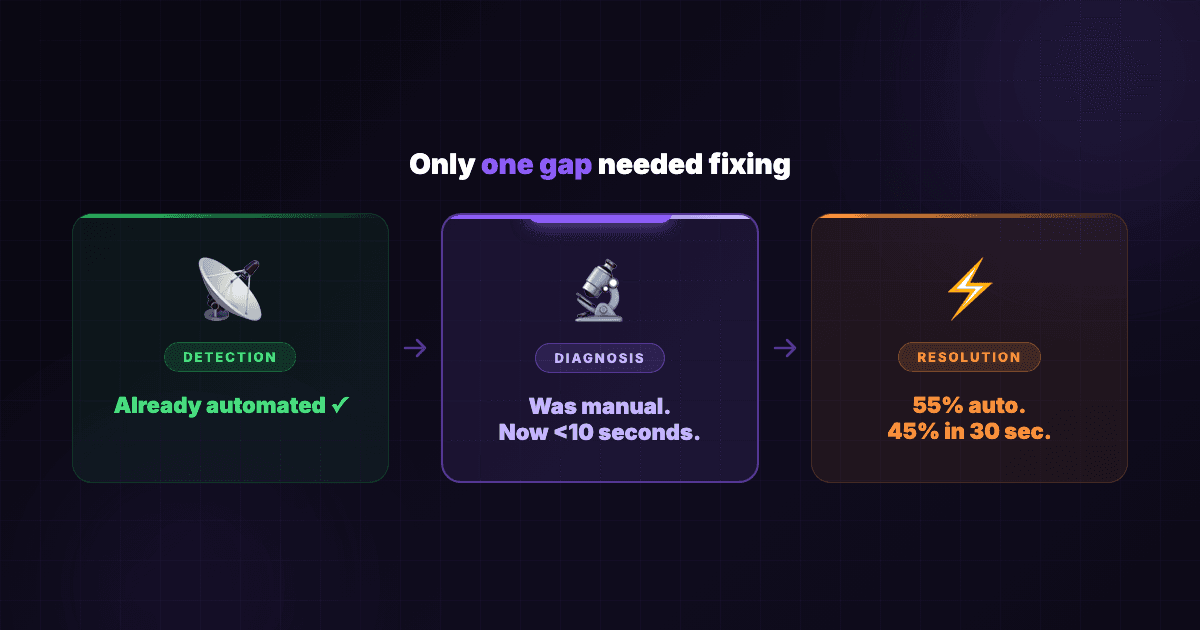
調査したところ、およそ55%の障害は一過性でした。高負荷時のデータベースロック、採用記録の確定におけるレースコンディション、時間差で解消するタイミングの問題などです。これらは誰かが確認する頃には既に解消していることが多く、結果を追跡するシステムがなければ、そのパターンは見えませんでした。各障害は「再試行すればよいだけ」のケースに見えず、すべてが調査に値するユニークな問題のように扱われていました。
早くからバックオフ付き再試行を導入することは可能でしたが、給与レコードに無自覚に再試行を掛けることはできません。再試行が許されるのは一過性であると確信できる場合だけです。構造的な問題であれば再試行は事態を悪化させる可能性があるため、どちらに該当するかの診断は必須です。本システムにより、その診断と(必要ならば)再試行の両方が数秒で完了するようになりました。
私たちが構築しました
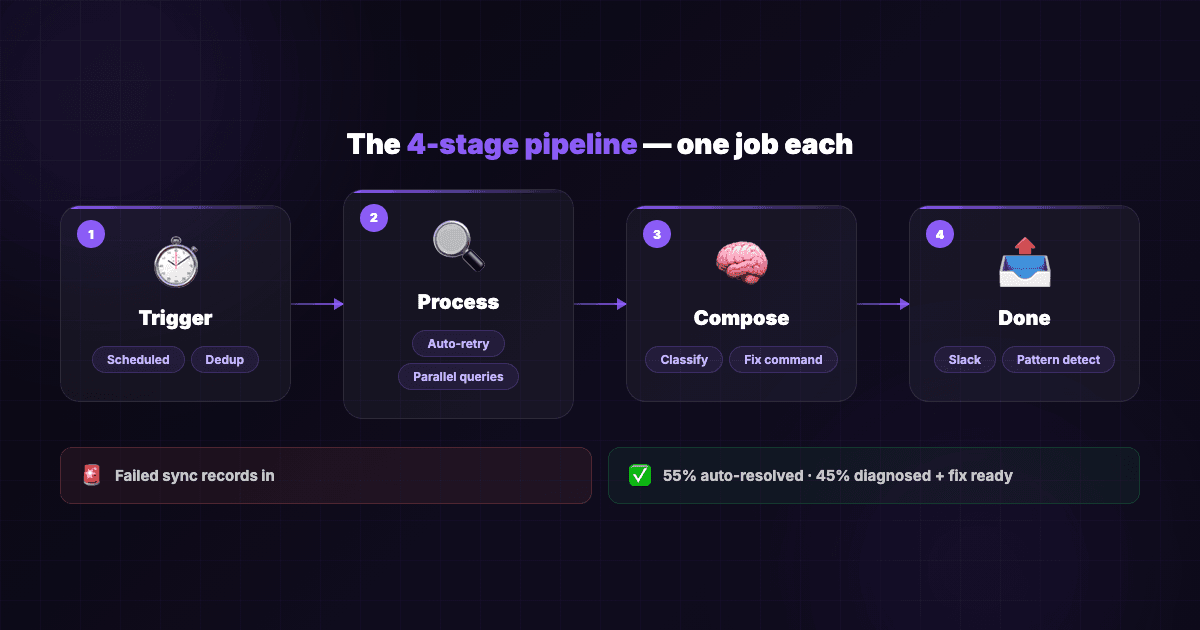
私たちは障害の調査をいかに速く行うかに注力するのではなく、そもそも調査が不要になるにはどうすればよいかを自問しました。その結果、Deelの内部AIオーケストレーションプラットフォームであるAkai上に、各ステージが特定の役割を持ち、手動の介入やエンジニアの起動を必要としない4段階のパイプラインを展開しました。
ステージ1:検出とバッチ化
数分ごとにこのステージが起動し、給与システムの失敗した同期をスキャンして重複を除去し、関連する障害をまとめてクリーンなバッチとして下流に渡します。Slackの通知や人手によるトリガーは不要です。
ステージ2:再試行と調査
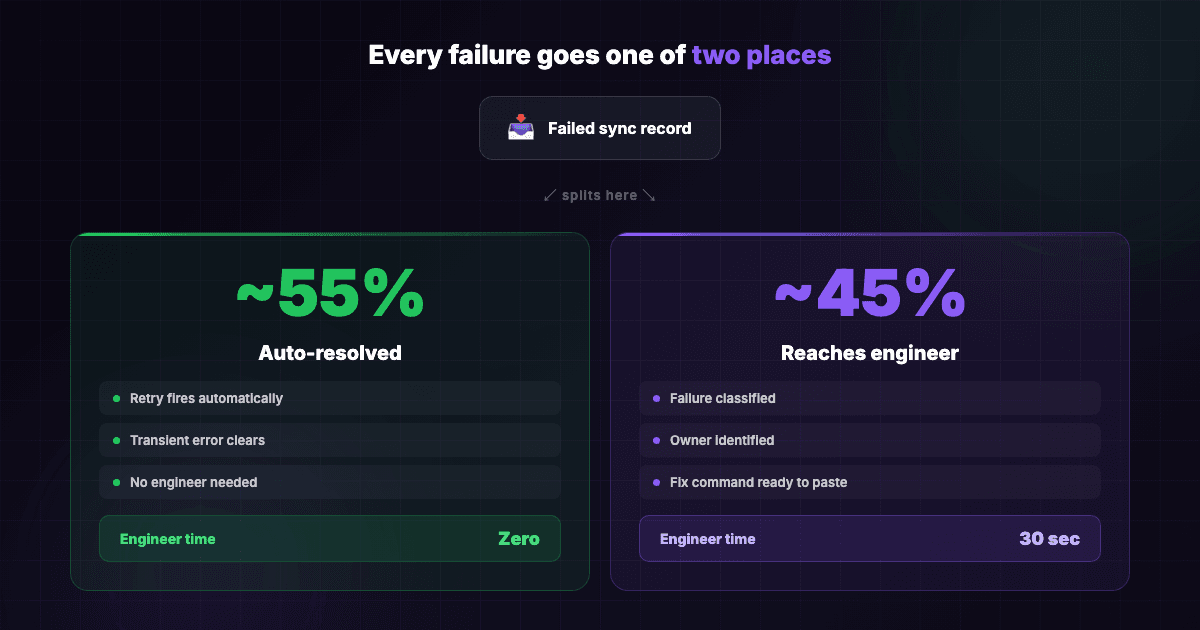
このステージではすべての障害に対して自動再試行を行い、およそ55%のケースではそれで事態が終了します—一過性のエラーが解消され、調査は不要になります。残りの45%については並列で広げて、採用記録の状態を確認したり、監視システムからログを引いたり、給与データベースを照会したり、コンプライアルールと突合したりします。これらは互いにブロックしないため、4つの別個のシステムにアクセスしても10秒未満で診断が完了します。
ステージ3:分類と修復
このステージはシステムのノイズに意味を与えます。障害を分類し、たとえば重複したSSN、無効な住所、税申告ステータスの欠落、誤ったルーティングデータなどに分けます。そして、以前はエンジニアの時間を大きく消費していた作業を代替します。すなわち、雇用主側、従業員側、あるいはDeel側のどちらの問題かを特定し、それを修正するための正確なコマンドを書き出します。
ステージ4:配信
最終ステージはすべてをSlack形式でまとめて配信します。障害ごとにセクションを設け、コピーペーストで使える修正コマンドと直接的なログリンクを添付します。また、同じ会社の複数の新入社員で同じエラーが繰り返されている場合は、個別のアラートを大量に送るのではなく、雇用主レベルの設定問題としてまとめて表示します。
受け入れませんでした、45分の問題
数字が示しています。
| 指標 | 導入前 | 導入後 |
|---|---|---|
| トリアージごとの時間 | 45分 | 10秒未満 |
| 同時対応上限 | 4〜6件でエンジニアが丸一日対応 | 同時に20件以上対応可能 |
| 自動解決率 | 0% | 55% |
| 年間で取り戻した時間 | — | 年間900時間以上 |
エンジニアがワークフローから消えたわけではありませんが、悩みの種は消えました。現在は約55%のケースが誰の介入もなく自己解決しており、残りは依然としてエンジニアに届きます。ただし、今では45分の調査ではなく30秒の確認で済むため、エンジニアは何が壊れているか、次に何をすべきかを正確に把握して対応できます。
どのように実現しているか
これはDeelに特有の仕組みではなく、アーキテクチャ自体も新規性があるわけではありません。どのインフラのトリアージ課題にも当てはまります。以下が我々の成功要因です。
順次ステージに、内部は並列処理。 各ステージは前の処理が終わった後に実行されますが、性能上の勝因はInvestigation(調査)ステージ内の並列処理です。ここでデータ取得が同時に走るため、どれかが他をブロックすることがなく、40秒の処理と10秒の処理の差が生まれます。
明確な障害分類。 Classificationステージでは構造化された障害の分類体系を用意しており、本番で新たな障害カテゴリが出てきた場合でも、プロンプトを1行変更するだけで対応できます。
ステージ間はきれいなJSONの受け渡し。 各ステージは受け取ったJSONを処理し、出力もJSONにするため、共有状態がなく、不可解な相互依存が発生しません。
即時再試行をデフォルトに。 多くの障害は一過性なので、ロジックは単純です:即時に再試行し、どの割合が自己解決するかを測定し、残りを調査します。
給与計算を超えて適用できます
給与システムは我々のユースケースに過ぎませんが、このパターンはインフラがノイジーになるあらゆる領域に拡張できます。API障害、データベースのインシデント、クラウドプロバイダーのエラー、あるいはカスタマーサポートのエスカレーションなど、高頻度でノイズが多く、その中にわずかなシグナルが埋もれているケースすべてに当てはまります。重要なのは、自動で修復できるものと人間の対応が必要なものを切り分けることです。具体的なツールは変わっても、基本的なロジックは同じです:再試行、診断、分類、ルーティング。
多くの組織はすべてを人間に投げて解決を期待しますが、採用が進みボリュームが増えるとチームが圧倒されます。可能なものは自動化し、判断が必要なものには人間の判断を残してください。
Deelが支援します
Deelのプラットフォームは給与計算の複雑さを管理しますので、エンジニアの皆様がそれを調査する時間を費やす必要はありません。私たちはAIでオーケストレーションされたワークフローを用いて、大量かつノイズの多い作業を管理します。その結果、エンジニアは本当に注力すべき業務に集中できます。つまり、システムに耐障害性を組み込み、問題がそもそも発生しないようにする設計に時間を使えるようになります。日常的に障害対応に追われる必要はなくなります。
Deelのデモをご予約ください、そして頭痛の種のないグローバル給与スケールの実際をご覧ください。
ライブデモ
ライブデモでDeelプラットフォームを体験できます
著者を紹介します
Harshil JainはDeelのバックエンド開発者として、拡張性の高いシステムの構築や複雑なエンジニアリング課題の解決に情熱を注いでいます。特にAIをはじめとする新しい技術の探究を楽しみながら、ソフトウェアエンジニアリングや働き方の未来について知見を発信しています。